LLM 供应商
AgenticX 支持的 LLM 供应商与配置方式。
LLM 供应商
对话和工具走 BaseLLMProvider。国内云有一方适配器;其余可用 LiteLLMProvider(OpenAI 兼容或 LiteLLM 模型 ID)。
已配置指 API 密钥或自定义 API 地址至少一项非空。只留官方默认 Base 不算。Ollama 这类本机服务必须填可访问地址。
实践案例:把供应商标成「已配置」
场景。 一家云填了密钥,本机服务填了自定义地址。
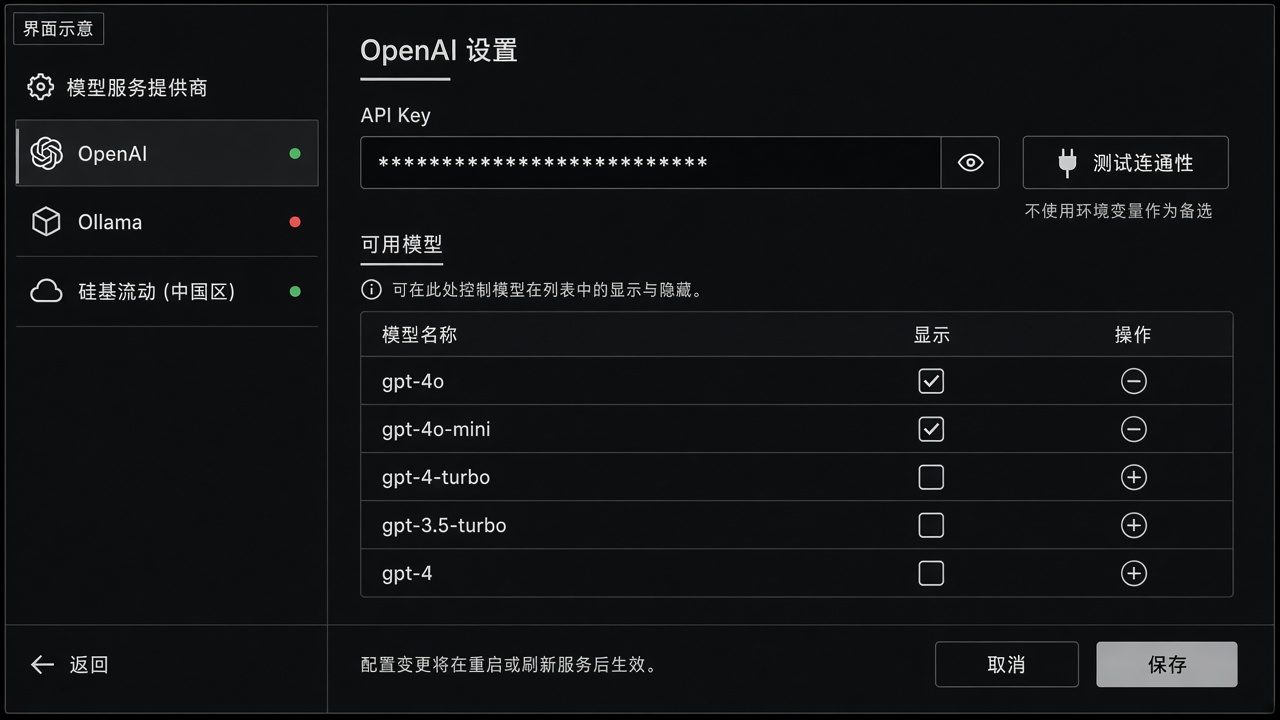
- 设置 → 供应商列表。侧栏状态点和详情 ON/OFF 必须一致:密钥或自定义 Base 非空才是绿。只留官方默认 Base 仍是红。
- Ollama:填可访问的 API 地址。空地址不算已配置。
- 点「测试连通性」(一个输入框,不要并列环境变量框)。拉模型要先弹出带 +/- 的可见性选择,不能把全部模型倒进聊天选择器。
- 清空密钥和自定义地址应自动视为关闭。
你会看到。 只有红 / 绿。保存后,新窗格的模型 pill 能选到已标记可见的模型。给 MiniMax M2 附图应出现窗格内警示,而不是供应商 400。
支持的供应商
| 供应商 | 主要 Python 类 | 视觉 | 说明 |
|---|---|---|---|
| OpenAI | OpenAIProvider (LiteLLMProvider) | 是(视模型而定) | 默认栈;GPT-4o 等支持视觉 |
| Anthropic | AnthropicProvider (LiteLLMProvider) | 是(视模型而定) | 需要时使用 anthropic/ 模型前缀 |
| Ollama | OllamaProvider (LiteLLMProvider) | 视模型而定 | 本地部署;通常为 ollama/<model> |
| Google Gemini | GeminiProvider (LiteLLMProvider) | 是(视模型而定) | LiteLLM gemini/ ID |
| Kimi / Moonshot | KimiProvider, MoonshotProvider | 否(常见对话 SKU) | 专用 HTTP 适配器;长上下文 |
| MiniMax | MiniMaxProvider, MinimaxProvider | M2* 对话系列不支持 | 内部自动补 openai/ 前缀;M2 系列不接受图片/音频输入 |
| VolcEngine Ark | ArkLLMProvider, ArkProvider, VolcEngineProvider | 视模型而定 | 字节豆包 / Ark 端点 |
| 智谱 GLM | ZhipuProvider, ZhiPuProvider | GLM-4V 等支持 | 专用适配器 |
| 百度千帆 | QianfanProvider, QianFanProvider | 视模型而定 | 配置中可能需要 secret_key |
| 阿里百炼 / Dashscope | BailianProvider, DashscopeProvider | 视模型而定 | 配置 Qwen-VL 等视觉模型时可用 |
| SiliconFlow | LiteLLMProvider | 视模型而定 | 将 base_url 指向 SiliconFlow OpenAI 兼容 API |
| LiteLLM(通用) | LiteLLMProvider | 视模型而定 | 任意 LiteLLM 支持的后端 |
| Azure OpenAI | LiteLLMProvider | 视模型而定 | azure/ 模型;需 api_version 与 Azure 密钥 |
| DeepSeek | LiteLLMProvider | 视模型而定 | 经 LiteLLM 路由 |
| Groq | LiteLLMProvider | 视模型而定 | 经 LiteLLM groq/ 模型 |
| Mistral | LiteLLMProvider | 视模型而定 | 经 LiteLLM mistral/ 模型 |
| Together AI | LiteLLMProvider | 视模型而定 | 经 LiteLLM |
| xAI | LiteLLMProvider | 视模型而定 | 经 LiteLLM |
ProviderResolver.PROVIDER_MAP 将配置键 openai、anthropic、ollama、zhipu、volcengine / ark、bailian、qianfan、kimi、minimax 映射到上表中的类。
用法示例
OpenAI
1from agenticx.llms import OpenAIProvider23llm = OpenAIProvider(4 model="gpt-4o",5 api_key="sk-...", # or rely on env / config6)7resp = llm.invoke("Summarize this in one line.")
Anthropic
1from agenticx.llms import AnthropicProvider23llm = AnthropicProvider(4 model="anthropic/claude-sonnet-4-20250514",5 api_key="sk-ant-...",6)7resp = llm.invoke([{"role": "user", "content": "Hello"}])
Ollama(本地)
1from agenticx.llms import OllamaProvider23llm = OllamaProvider(4 model="ollama/qwen2.5:7b",5 base_url="http://127.0.0.1:11434",6)7resp = llm.invoke("Ping")
MiniMax
1from agenticx.llms import MinimaxProvider23llm = MinimaxProvider(4 model="MiniMax-M2.5",5 api_key="...",6 # base_url defaults to https://api.minimax.chat/v17)8resp = llm.invoke("Reply with OK.")
LiteLLM
1from agenticx.llms import LiteLLMProvider23# Example: third-party OpenAI-compatible endpoint (e.g. SiliconFlow)4llm = LiteLLMProvider(5 model="openai/Qwen/Qwen2.5-7B-Instruct",6 api_key="...",7 base_url="https://api.siliconflow.cn/v1",8)9resp = llm.invoke("Hello")
鉴权配置轮换
AuthProfileManager(agenticx.llms.auth_profile)为同一供应商轮换多个 API 密钥(或逻辑 profile),并将冷却元数据持久化到 JSON 文件(先写 .tmp 再原子替换)。
- `get_current()` — 选取下一个可用 profile(优先可用项,按
last_used排序;冷却中的 profile 按cooldown_until排队)。 - `mark_success(profile_name)` — 清除该 profile 的错误状态与冷却时间戳。
- `mark_failure(profile_name, failure_type)` — 递增
error_count、设置failure_type,并对cooldown_until应用指数退避。 - `classify_failure(exc)` — 根据异常消息启发式映射为
billing、auth、rate_limit或other。
退避策略(在 _compute_cooldown_ms 中实现):
| 失败类型 | 基准 | 上限 | 每步倍率 |
|---|---|---|---|
billing | 5 小时 | 24 小时 | 2 ** min(error_count - 1, 10) |
rate_limit、auth、other 等 | 60 秒 | 1 小时 | 5 ** min(error_count - 1, 3) |
BaseLLMProvider.invoke_with_profile(messages, api_key=...) 会转发到 invoke(..., api_key=api_key),调用方可在不替换 provider 实例的情况下注入轮换后的密钥。
故障转移路由
FailoverProvider 包装两个 provider:主路与备路。对 invoke、ainvoke、stream、astream 和 stream_with_tools,除非主路处于冷却期,否则优先尝试主路。
- `failure_threshold`(默认
3)— 主路连续失败多少次后进入冷却。 - `cooldown_duration`(默认
60秒)— 达到阈值后主路被旁路的时间窗口。 - 主路调用成功会重置失败计数并清除冷却。
1from agenticx.llms import FailoverProvider, OpenAIProvider, AnthropicProvider23llm = FailoverProvider(4 primary=OpenAIProvider(model="gpt-4o", api_key="..."),5 fallback=AnthropicProvider(model="anthropic/claude-sonnet-4-20250514", api_key="..."),6 failure_threshold=3,7 cooldown_duration=120.0,8)
响应缓存
ResponseCache 是内存存储,以 prompt 字符串的 SHA-256(截断)为键。条目带 TTL(ttl_seconds,默认 300)并采用 LRU 淘汰(max_entries,默认 100)。它不会自动接入 LiteLLMProvider;开发循环中需要降本时可自行包装调用。
1from agenticx.llms import OpenAIProvider, ResponseCache23llm = OpenAIProvider(model="gpt-4o-mini", api_key="...")4cache = ResponseCache(ttl_seconds=300, max_entries=100)56def cached_invoke(text: str):7 hit = cache.get(text)8 if hit is not None:9 return hit10 out = llm.invoke(text)11 cache.put(text, out)12 return out
stats() 返回命中、未命中、条目数与命中率。
对话清洗器
模型调用前,agent_runtime 会对聊天历史执行 _sanitize_context_messages。该流水线在更广意义上是 provider 感知的:它强制合法的 assistant / tool 消息链,避免上游 API 看到孤立的 tool 行或未闭合的 tool_calls。
行为(简化):
- `tool` 消息 仅在前序 assistant
tool_calls列表中存在对应tool_call_id,且连续 tool 响应已全部满足时保留。 - 带 `tool_calls` 的 assistant 消息 仅当历史中每个 call id 都有匹配的 tool 响应时保留;否则剥离
tool_calls并保留文本内容。
这可减少编辑、重试或部分持久化后工具环断裂导致的 provider 400 错误。
视觉与图片输入
当后端与模型支持多模态时,框架会传递相应内容。按厂商约束,MiniMax M2 对话系列(含 M2、M2.1、M2.5、M2.7 及 *-highspeed SKU;不含 id 中带 vl / vision 的型号)不接受图片或音频输入。
Studio 会在 completion 请求前为这些模型剥离 image_inputs。若附件必须送达 LLM,请选用支持视觉的模型。
供应商配置(环境变量)
下表为 AgenticX 配置加载器通常与 ~/.agenticx/config.yaml 中 providers.<name> 配对使用的变量。LiteLLM 还可能根据模型 id 读取额外变量。
| 变量 | 用途 |
|---|---|
OPENAI_API_KEY | OpenAI |
OPENAI_API_BASE | OpenAI 兼容端点覆盖(可选) |
ANTHROPIC_API_KEY | Anthropic |
ANTHROPIC_API_BASE | Anthropic Base URL 覆盖(可选) |
ZHIPU_API_KEY | 智谱 |
ARK_API_KEY | 火山引擎 Ark(volcengine / ark provider) |
VOLCENGINE_ACCESS_KEY, VOLCENGINE_SECRET_KEY | Ark / Volcengine 备用鉴权路径 |
DASHSCOPE_API_KEY | 阿里百炼 / Dashscope |
QIANFAN_ACCESS_KEY | 百度千帆(secret_key 常在 YAML 中配置) |
MOONSHOT_API_KEY | Kimi / Moonshot |
MINIMAX_API_KEY | MiniMax |
AGX_MAX_TOOL_ROUNDS | 工具轮次上限(全局运行时) |
AGX_CHROMIUM_QUIET | Desktop Chromium 日志降噪(可选) |
Ollama 通常在 YAML 中配置 base_url(例如 http://localhost:11434);本地推理无需密钥。